«МедиАрхив»
Система управления медиаконтентом «МедиАрхив»: телекомпании и медиапроизводители держат в ней видеоархивы целиком — от загрузки исходников до выдачи собранных пакетов монтажу и партнёрам.
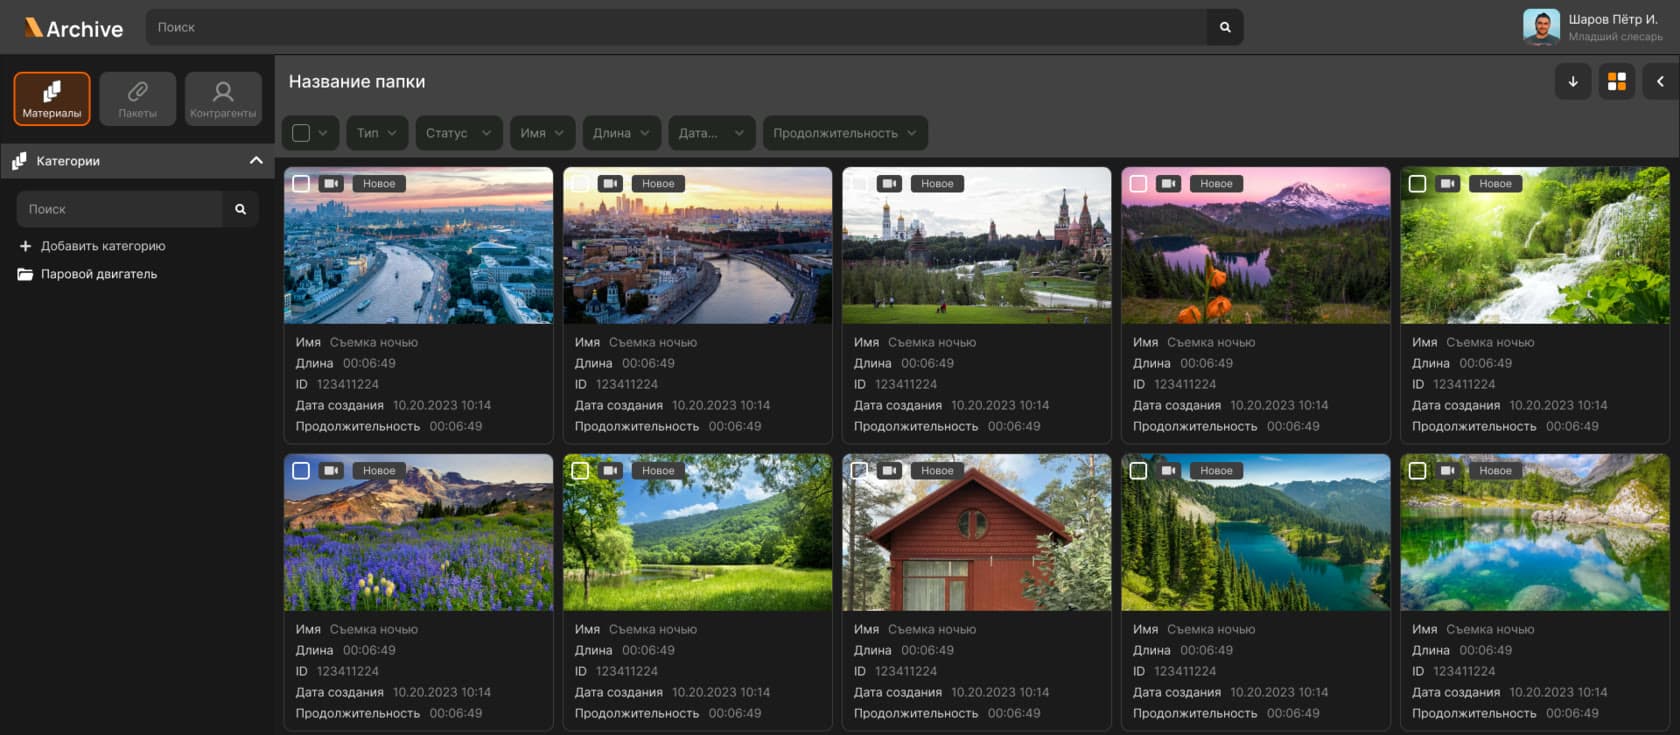
Результат
- −70%
- времени на обработку контента: прокси-копии и разбор на сцены идут автоматически
- 3
- варианта поставки: SaaS, коробка и установка в инфраструктуре заказчика
- 4
- роли доступа: администратор, архивист, контент-менеджер и редактор
Экраны продукта
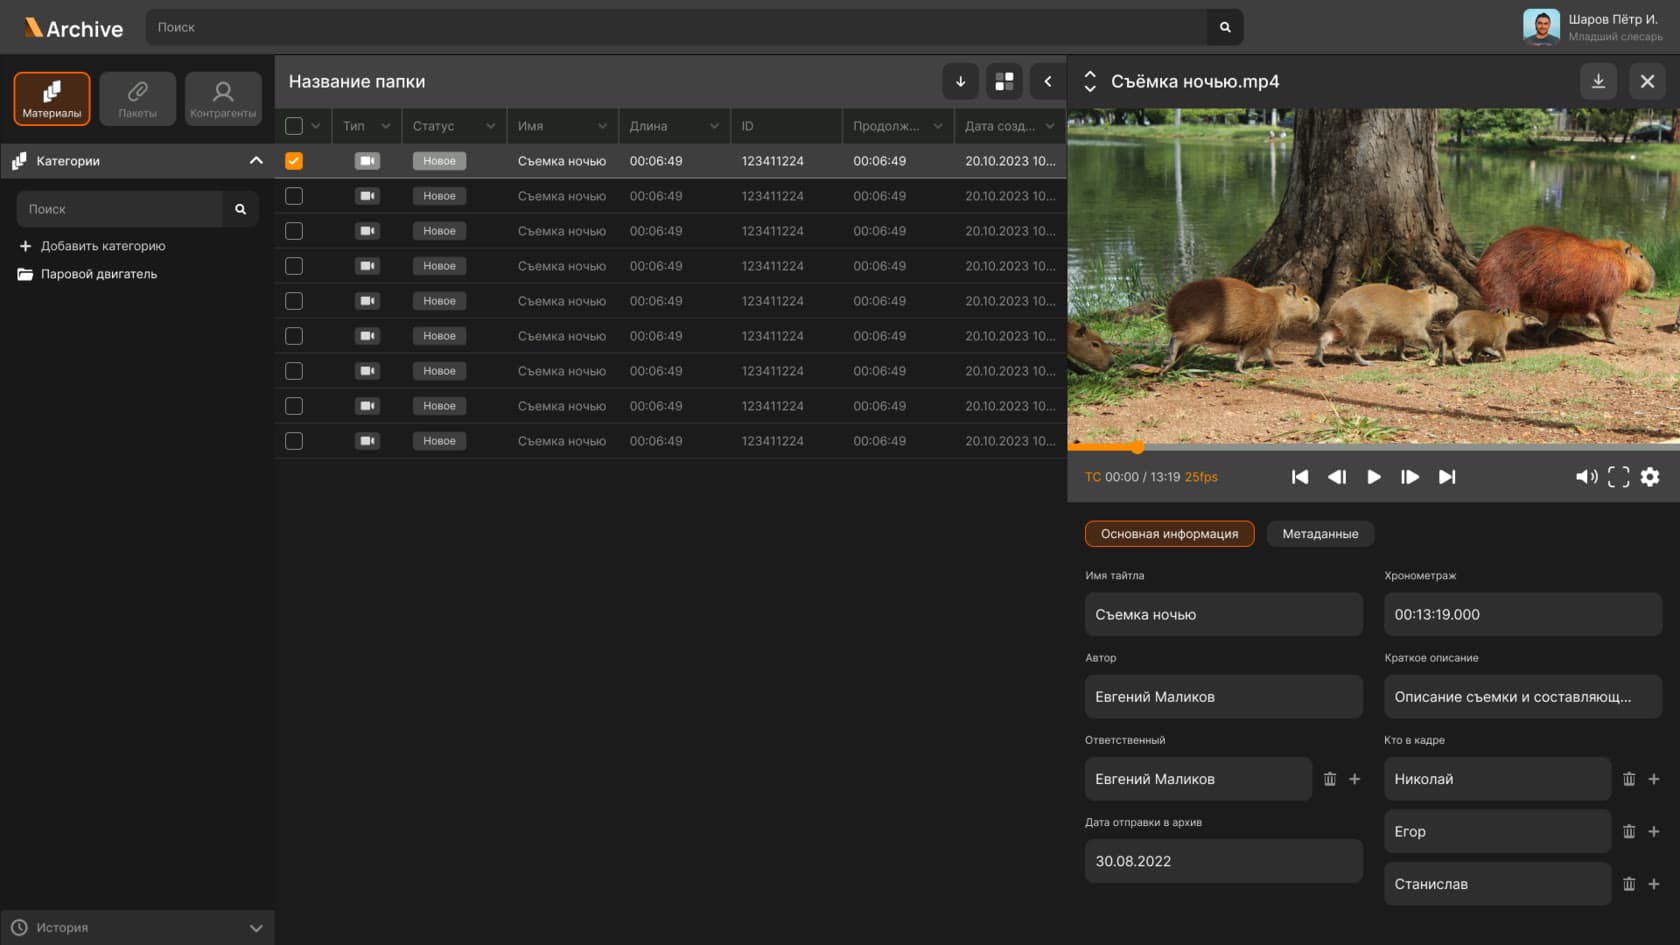
Просмотрщик: слева грид материалов, справа плеер с таймкодом и панель метаданных. Поля панели приходят из конфигурации, а не зашиты в код.
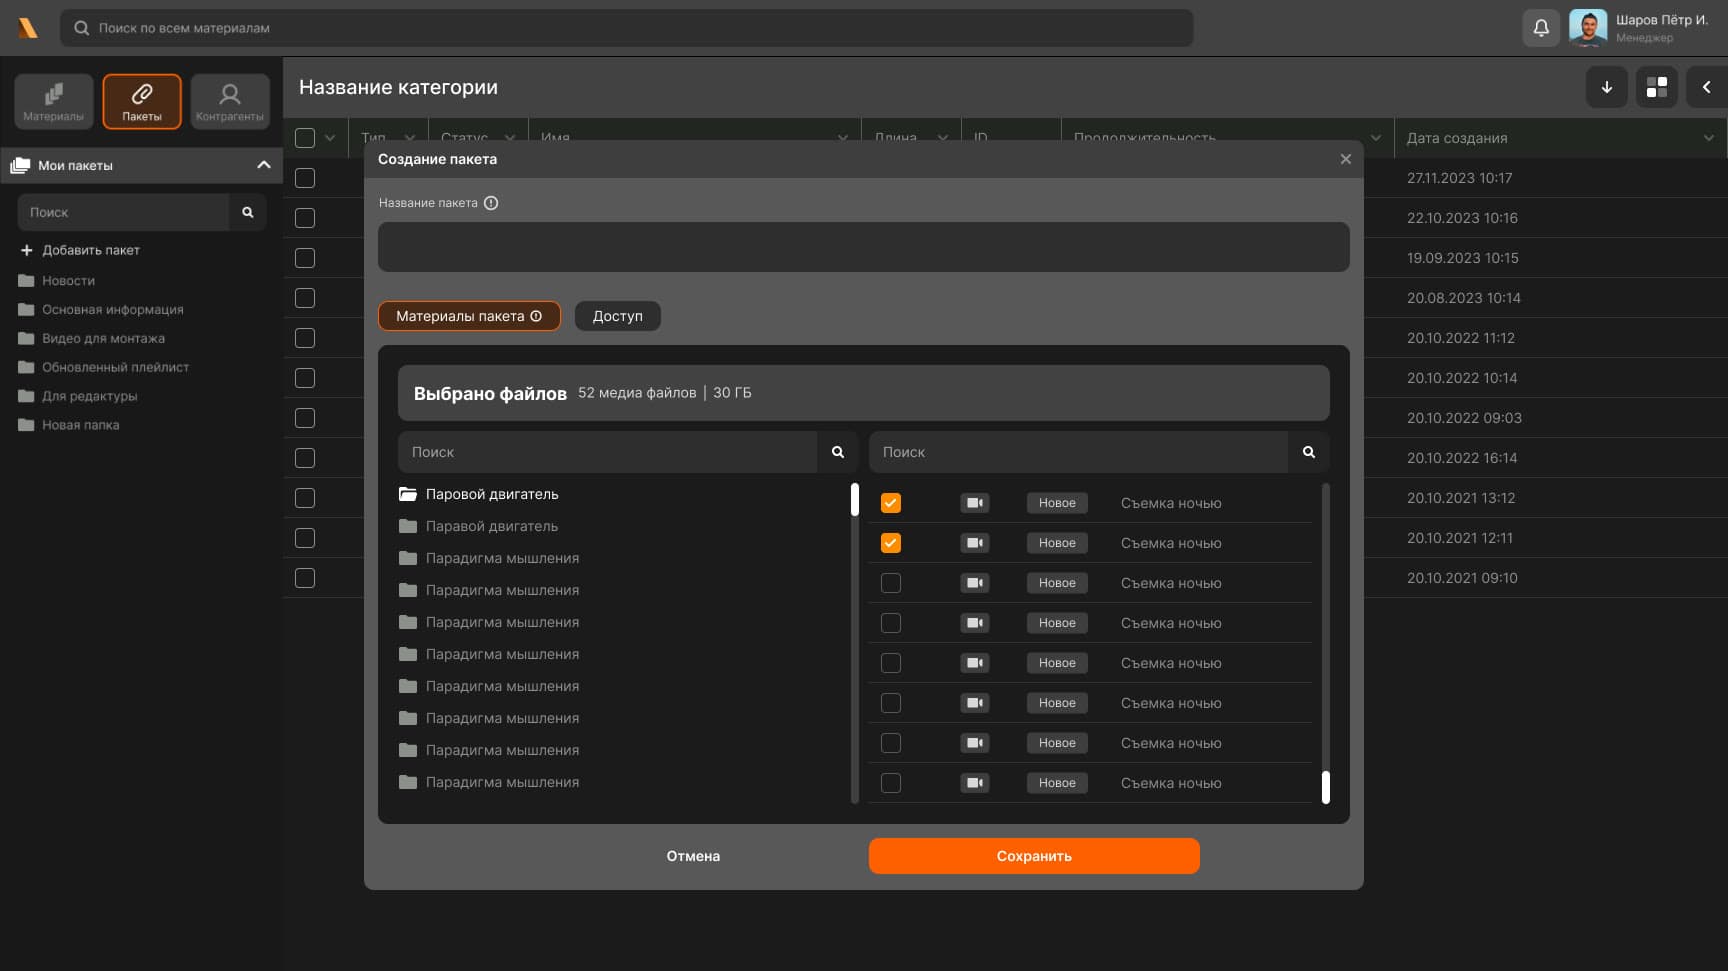
Сборка пакета: материалы набираются из дерева категорий, счётчик показывает объём — 52 файла и 30 ГБ. На соседней вкладке задаётся, кому пакет будет доступен.
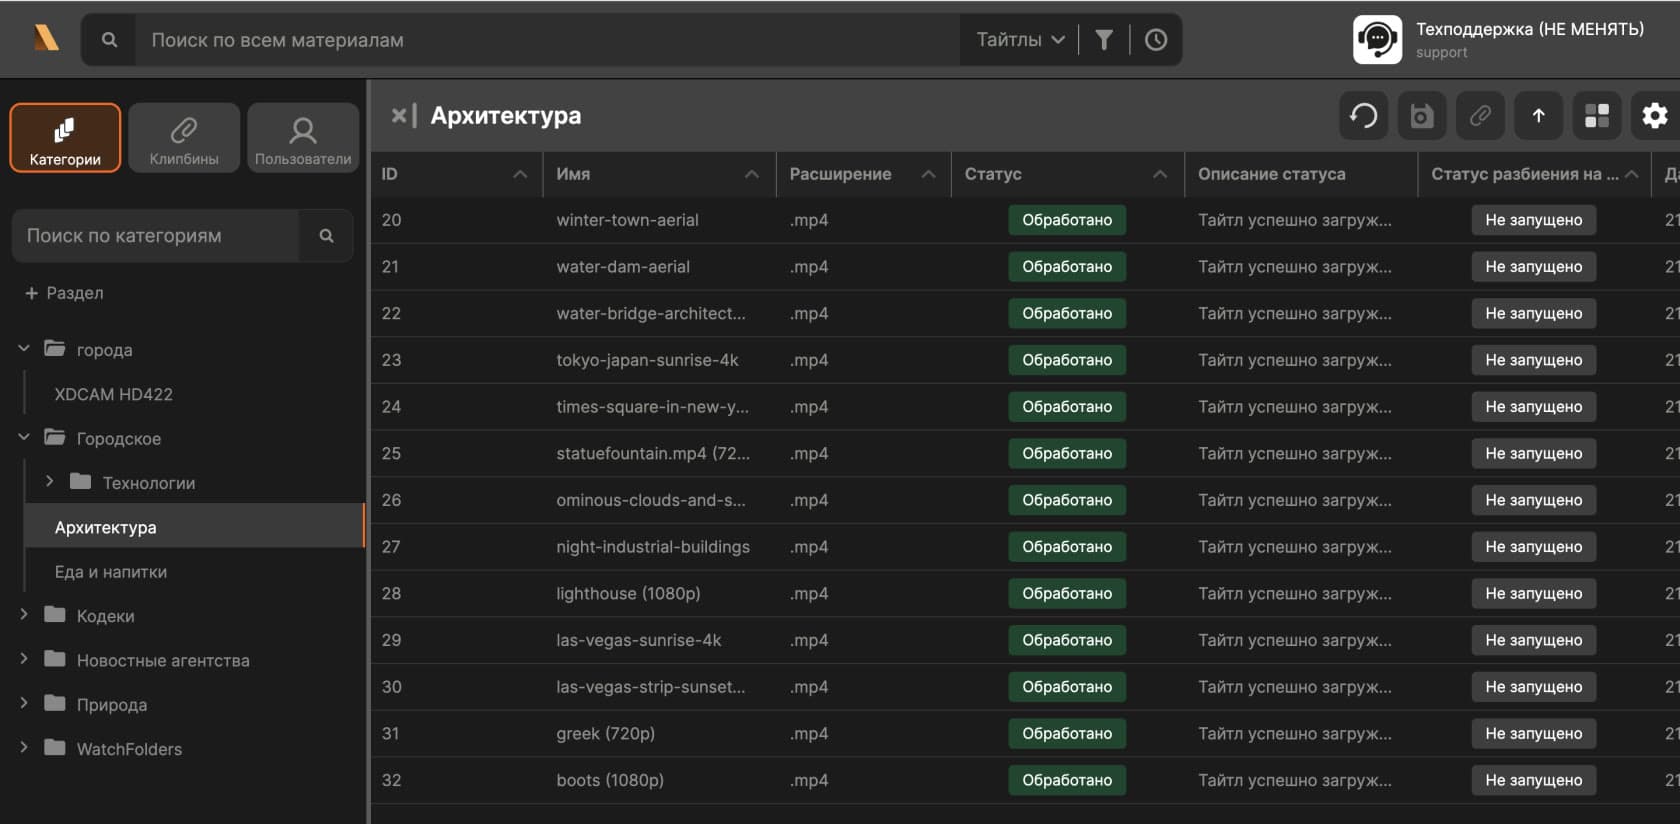
Грид категории: у каждого материала свой статус загрузки и статус разбиения на сцены — по ним видно, на каком шаге пайплайна файл находится прямо сейчас.
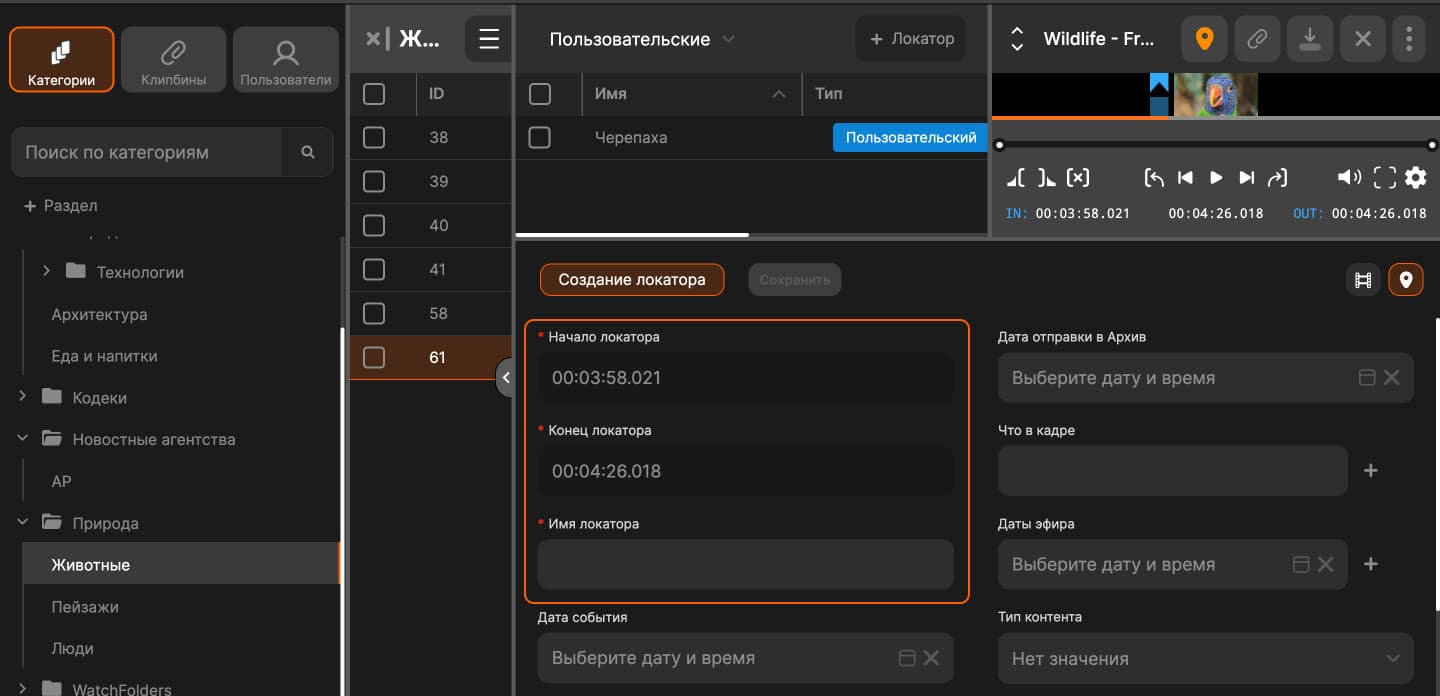
Режим разметки: локатор задаётся таймкодами IN и OUT прямо в плеере. Сцены, найденные ИИ, лежат в том же гриде и после ручной правки становятся пользовательскими.
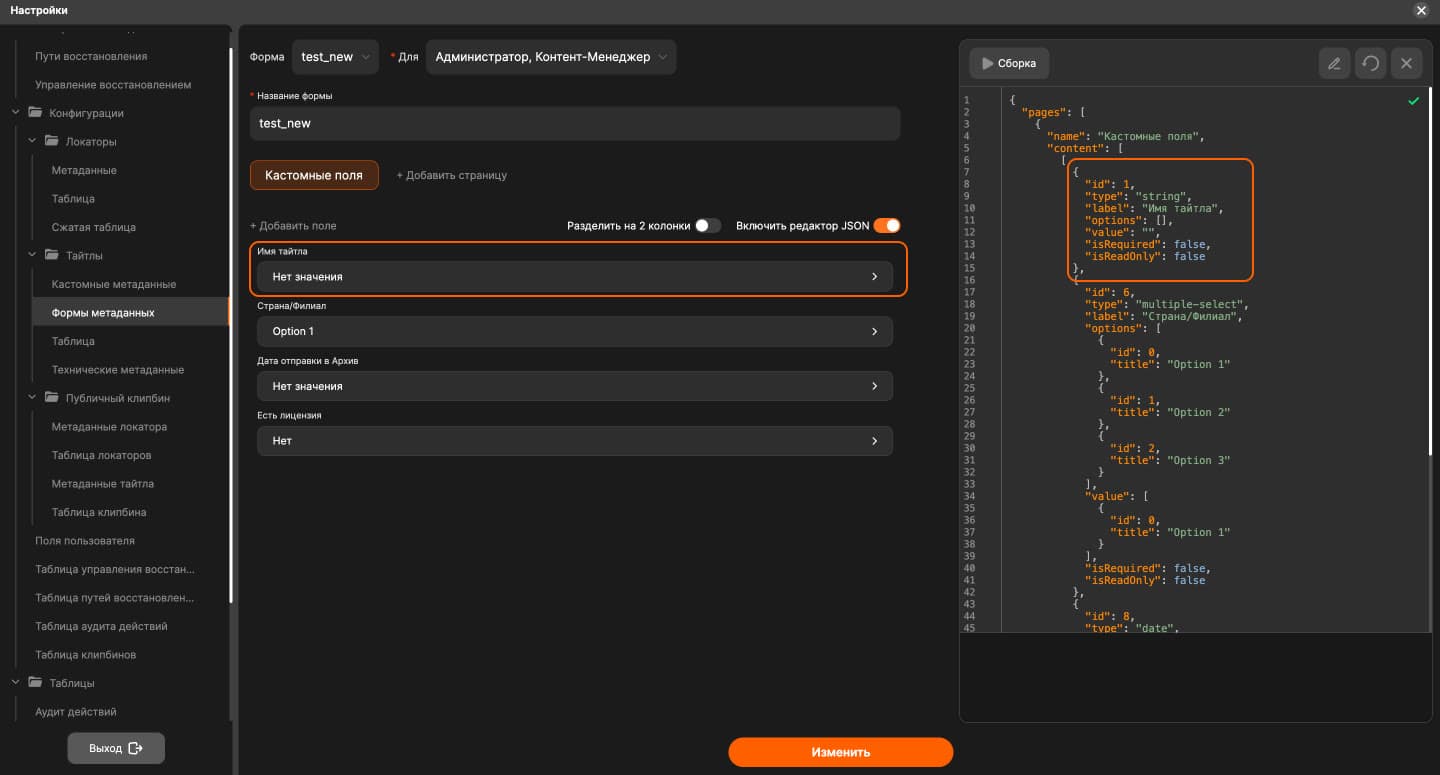
Конструктор форм метаданных: слева собранная форма, справа её JSON. Форма привязана к ролям, поэтому каждая инсталляция описывает свой архив без релиза.
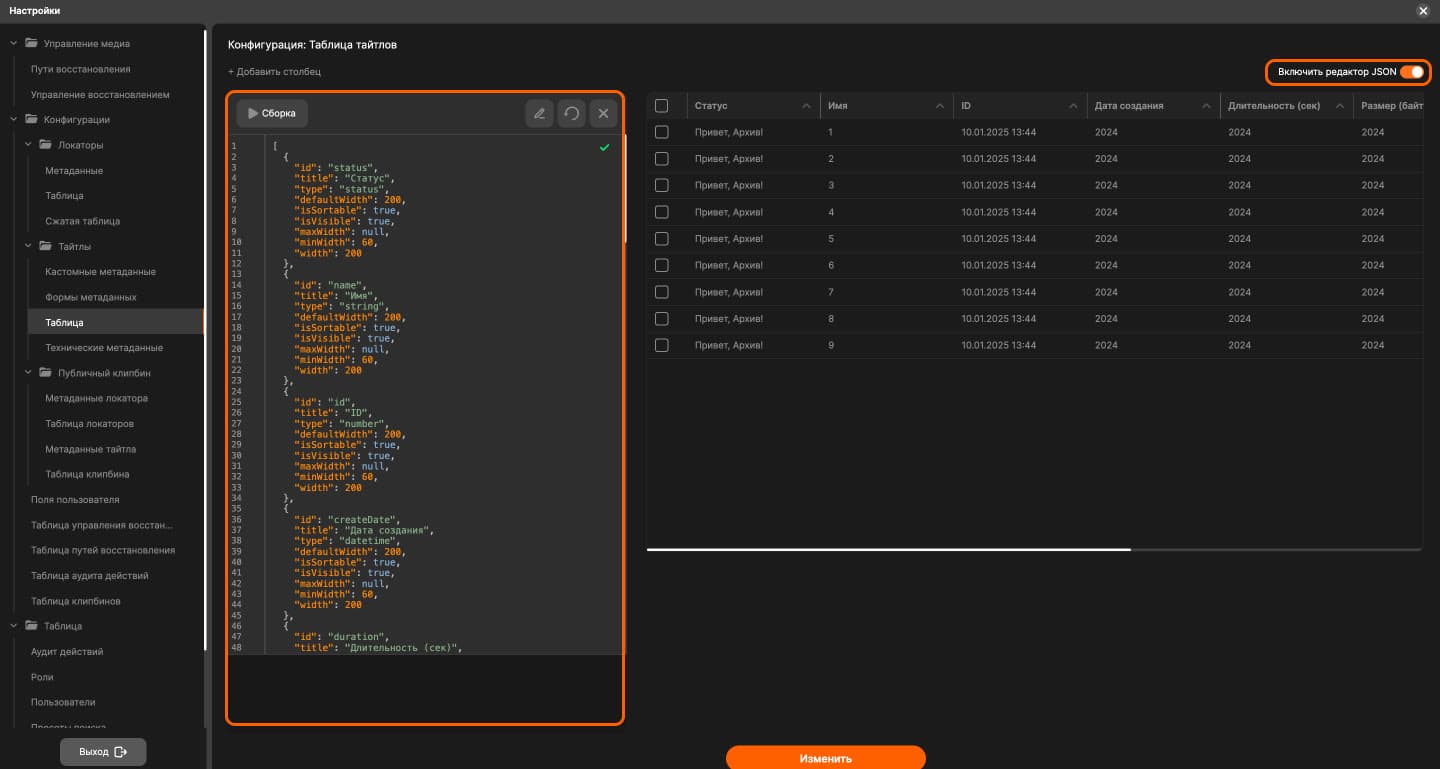
Конфигурация таблицы материалов: колонки, их типы, ширины и видимость описываются JSON-ом, предпросмотр справа обновляется сразу.
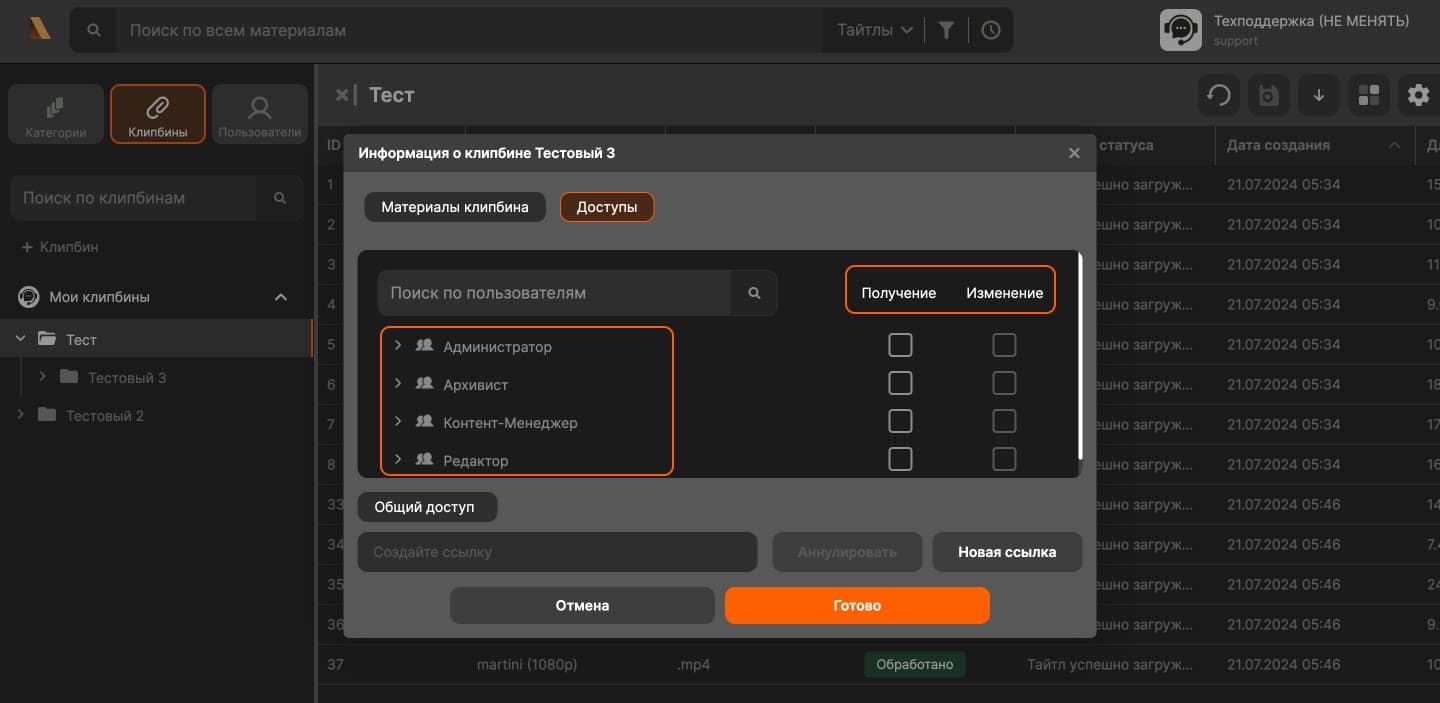
Доступы к клипбину: права на получение и изменение выдаются по ролям. Отдельно генерируется публичная ссылка, которую можно аннулировать.
Задача бизнеса
Видеоархив телекомпании — это терабайты исходников, к которым возвращаются годами. Пока материалы описывают вручную, а метаданные живут в таблицах, редактор тратит на поиск нужного кадра больше времени, чем на монтаж. Продукту нужно было закрыть весь путь материала: инжест, описание, хранение, обработку и выдачу — и при этом ставиться в трёх режимах, потому что телеканал не выносит архив в чужое облако. Ещё одно требование: у каждого заказчика свой набор полей описания и свои роли, и менять их нельзя релизом ради одной инсталляции.
Моя роль
Техлид продукта: отвечал за архитектуру «МедиАрхива» и за то, чтобы клиент, доменный бэкенд и медиапайплайн собирались в один продукт, а не в три отдельных сервиса. Делил систему на модули, задавал контракты между частями, вёл код-ревью, разбирал инциденты на инсталляциях и вместе с командой планировал релизы — включая версию 1.8 с ИИ-поиском, кастомными статусами материалов и работой в реальном времени.
Решение
Клиент — React с Effector: дерево категорий, гриды, просмотрщик и настройки живут в одном состоянии, поэтому таблица, плеер и панель метаданных не расходятся между собой. Серверная часть разделена: NestJS держит домен — категории, клипбины, права, метаданные, — а Python-сервисы на FastAPI занимаются медиа: прокси-копии, тамбнейлы, разбиение на сцены. Между ними RabbitMQ, поэтому долгая обработка не блокирует интерфейс и переживает перезапуск сервиса. Данные лежат в MongoDB и PostgreSQL. Структуру системы не зашивали в код: таблицы и формы метаданных описываются JSON-конфигурациями с редактором и живым предпросмотром прямо в настройках, а форма привязывается к роли — архивист и редактор видят разные поля одного материала. Инжест идёт через WatchFolder: папка на машине пользователя синхронизируется с категорией и продолжает загрузку после сетевых сбоев. Разметка материала — локаторы по таймкодам IN/OUT; сцены, найденные ИИ, попадают в тот же грид и после ручной правки становятся пользовательскими. Сборка и раскатка — Docker и Jenkins; продукт ставится как SaaS, коробкой и в контуре заказчика. «МедиАрхив» зарегистрирован в Роспатенте и включён в Единый реестр российского ПО.